一种中文知识图谱跨分块实体融合与关系去重方法及系统
专利交底书
交底书名称*
一种中文知识图谱跨分块实体融合与关系去重方法及系统
发明人*
郭阔
联系方式*
13261089257
邮箱*
专利类型*
☑发明
☐实用新型
技术交底书是将创新技术形成专利文献的基本素材,请全面、清楚地进行填写,使一般技术人员/专利代理人能够理解和实施。
一、本发明的名称
一种中文知识图谱跨分块实体融合与关系去重方法及系统
二、发明点概述
本发明涉及自然语言处理、知识图谱构建、中文文本处理及数据库技术领域,具体涉及一种面向中文长文本的跨分块知识图谱实体融合与关系去重方法。
在对中文长文档构建知识图谱时,通常需要将长文档划分为多个文本分块,再分别执行实体识别和关系抽取。由于不同文本分块可能分别描述同一实体或同一关系,容易产生实体名称不统一、同名实体误合并、关系端点不一致、重复关系以及来源证据无法追溯等问题。
本发明首先通过外部标识索引、名称别名索引和类型分区语义向量索引生成候选实体集合,避免将新增实体与全部历史实体逐一比较;然后通过硬冲突检测和多特征一致性评分确定实体融合状态,生成统一实体标识;在此基础上,根据关系本体对关系类型、方向和限定属性进行标准化,并结合主体实体标识、标准关系类型、客体实体标识、有效时间、关系极性及限定属性生成关系唯一标识;最后对重复关系的来源证据进行聚合,并通过幂等事务完成知识图谱的增量写入。
本发明的核心不是简单地进行字符串匹配或三元组去重,而是将候选检索、冲突检测、多特征融合、关系语义归一、来源证据聚合和增量一致性控制组合为一体化处理流程。
2.1 现有技术的技术方案
现有中文知识图谱构建方法通常包括:
获取待处理中文文档;
将中文文档划分为多个文本片段;
对各文本片段分别执行实体识别和关系抽取;
根据实体名称或实体描述进行实体匹配;
根据主体、关系类型和客体组成的三元组进行关系去重;
将处理结果写入知识图谱数据库。
部分现有方法采用编辑距离或语义向量计算实体名称相似度,但通常缺少外部标识冲突、实体类型冲突和时空属性冲突的优先判断
2.2 现有技术缺点
(1)中文实体名称表达不统一
同一实体可能具有全称、简称、曾用名、英文名称和证券简称等多种表达方式,仅通过字符串完全匹配容易产生重复实体。
(2)同名或近似名称实体容易被错误合并
不同实体可能具有相同或相似名称。如果仅依据名称相似度或描述向量相似度进行融合,容易忽略统一社会信用代码、产品型号、实体类型、时间和空间等冲突信息。
(3)跨文本分块指代难以解析
中文文本中经常使用“该公司”“上述企业”“其”“该机构”等指代形式,导致关系主体或客体无法准确映射至对应实体。
(4)关系类型归一过于简单
“持股”与“控股”、“投资”与“增资”等关系具有一定关联,但并非完全等义。若直接映射为同一关系类型,容易造成关系语义丢失。
(5)传统关系唯一标识不够完整
仅采用“主体、关系类型、客体”作为关系唯一标识,可能错误合并不同时期、不同金额、不同持股比例或者肯定与否定的关系事实。
(6)来源证据缺少独立性判断
多个网站转载同一原始内容时,简单统计文档数量会重复计算同一来源,导致关系可信度被不合理提高。
(7)增量更新容易产生数据不一致
同一文档被重复处理、文档内容发生修改或多个任务并发写入时,可能产生重复证据、关系端点不一致或部分数据写入失败等问题。
2.3 本技术方案
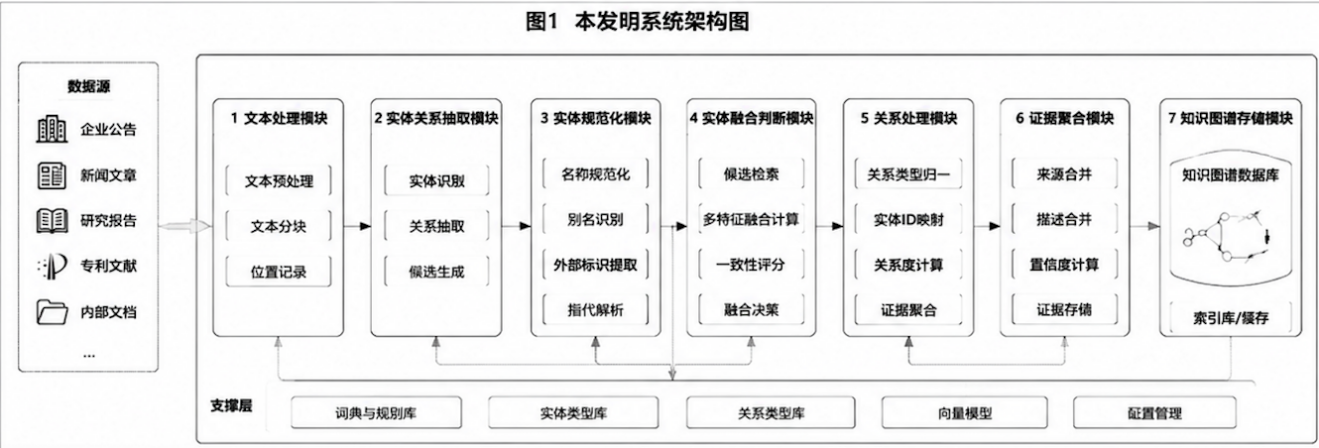
本发明主要解决以下问题:
减少实体候选比较数量,提高实体匹配效率;
降低同一实体未融合和不同实体误融合的概率;
实现跨文本分块的中文指代解析;
防止不同时间、极性或限定属性的关系被错误去重;
保留实体融合和关系去重的来源及计算依据;
避免转载来源被重复计入关系可信度;
保证知识图谱增量更新的幂等性和数据一致性。
三、本技术方案的详细阐述
3.1 系统整体流程
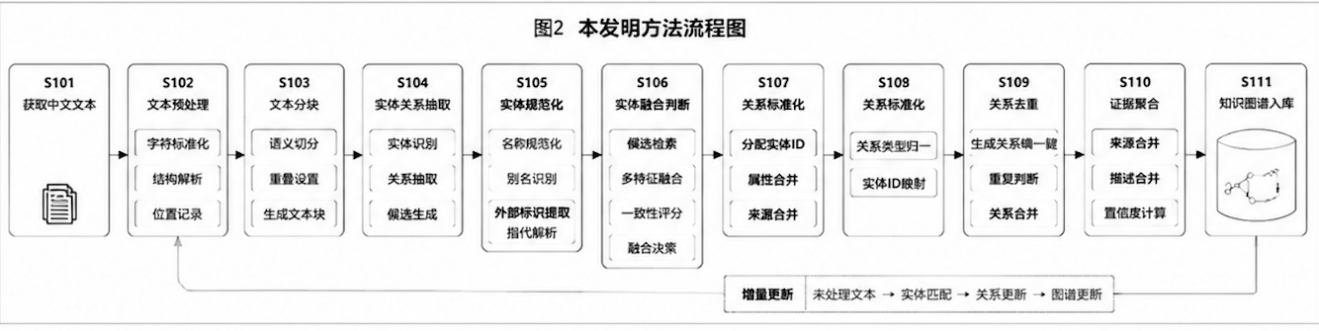
3.1.1 数据结构设计
在一种实施方式中,系统至少设置以下数据记录。
文档记录包括:
document_id:文档标识;
document_version:文档版本;
content_hash:文档内容指纹;
source_uri:来源地址;
publisher_id:来源发布主体;
publish_time:发布时间;
raw_text:原始文本;
normalized_text:规范化文本;
process_status:处理状态。
其中,content_hash可通过SHA-256或其他哈希算法对规范化后的文档内容进行计算。
2. 文本分块记录ChunkRecord
文本分块记录包括:
chunk_id:文本分块标识;
document_id:所属文档标识;
document_version:所属文档版本;
chunk_order:文本分块顺序;
section_path:章节路径;
normalized_text:文本分块内容;
original_start:对应原文起始位置;
original_end:对应原文结束位置;
chunk_hash:文本分块内容指纹。
3. 实体提及记录MentionRecord
实体提及记录包括:
mention_id:实体提及标识;
raw_name:原始名称;
normalized_name:规范化名称;
entity_type:实体类型;
aliases:别名集合;
external_ids:外部标识集合;
description:实体描述;
semantic_vector:语义向量;
document_id:文档标识;
chunk_id:文本分块标识;
mention_start:原文起始位置;
mention_end:原文结束位置;
extraction_confidence:抽取置信度;
coreference_chain_id:指代链标识。
4. 统一实体记录EntityRecord
统一实体记录包括:
entity_id:统一实体标识;
canonical_name:标准实体名称;
entity_type:实体类型;
aliases:别名集合;
external_ids:外部标识集合;
attributes:实体属性集合;
mention_ids:实体提及集合;
source_chunks:来源文本分块集合;
entity_confidence:实体可信度;
entity_version:实体版本;
active_status:有效状态。
5. 关系提及记录RelationMentionRecord
关系提及记录包括:
relation_mention_id:关系提及标识;
subject_mention_id:主体提及标识;
raw_relation:原始关系表达;
object_mention_id:客体提及标识;
relation_time:关系时间;
polarity:关系极性;
qualifiers:关系限定属性;
extraction_confidence:抽取置信度;
document_id:文档标识;
chunk_id:文本分块标识;
relation_start:原文起始位置;
relation_end:原文结束位置。
关系极性至少包括肯定、否定和不确定。
6. 目标关系记录RelationRecord
目标关系记录包括:
relation_id:目标关系标识;
relation_key:关系指纹;
subject_entity_id:主体统一实体标识;
canonical_relation_id:标准关系标识;
object_entity_id:客体统一实体标识;
effective_time:有效时间;
polarity:关系极性;
identity_qualifiers:身份限定属性;
evidence_ids:证据集合;
relation_confidence:关系可信度;
conflict_status:冲突状态;
relation_version:关系版本;
active_status:有效状态。
7. 来源证据记录EvidenceRecord
来源证据记录包括:
evidence_id:证据标识;
relation_id:目标关系标识;
document_id:文档标识;
document_version:文档版本;
chunk_id:文本分块标识;
original_span:原文位置;
support_text:支持文本;
source_cluster_id:来源簇标识;
evidence_confidence:证据置信度;
idempotency_key:幂等键;
active_status:有效状态。
8. 融合操作日志MergeLog
融合操作日志包括:
operation_id:操作标识;
source_entity_id:融合前实体标识;
target_entity_id:融合后实体标识;
merge_reason:融合原因;
feature_snapshot:评分特征快照;
score:实体一致性评分;
before_version:操作前版本;
after_version:操作后版本;
affected_relation_ids:受影响关系集合;
operation_time:操作时间;
rollback_status:回退状态。
S101:获取中文文本数据
获取待处理中文文档,为每个文档生成文档标识document_id,并根据文档内容生成内容指纹content_hash。
所述中文文档包括企业公告、新闻文章、技术文档、专利文献、研究报告和企业内部知识库文档。
S102:中文文本预处理
对中文文本执行:
Unicode编码归一化;
繁体转简体;
全角半角转换;
标点及特殊字符标准化;
标题、章节、段落、表格和列表识别;
原始文本与标准化文本之间的位置映射。
位置映射用于将实体及关系定位至原始文档中的具体文本位置。
S103:文本分块
按照章节边界、段落边界和预设长度将中文长文本划分为多个文本分块。
相邻文本分块之间可以保留预设长度的重叠文本。每个文本分块至少包括:
chunk_id;
document_id;
分块顺序;
章节路径;
文本内容;
原文位置;
分块内容指纹。
S104:实体关系候选抽取
对各文本分块执行实体关系抽取。
实体候选至少包括实体名称、实体类型、实体描述、外部标识、来源位置和抽取置信度。
关系候选至少包括关系主体、原始关系类型、关系客体、有效时间、关系极性、关系限定属性、来源位置和抽取置信度。
S105:跨分块指代处理
识别“该公司”“上述企业”“其”“该机构”等指代提及,并从当前文本分块及相邻文本分块中获取先行实体候选。
根据实体类型兼容程度、文本距离、句法角色和章节主题计算指代匹配评分。当最高指代匹配评分达到预设阈值,并且与次高评分之间的差值达到预设间隔时,将指代提及关联至对应先行实体。
S106:中文实体规范化处理
对实体候选进行规范化,包括:
名称字符格式统一;
组织机构后缀和地域前缀识别;
简称、曾用名、英文名称和英文缩写识别;
统一社会信用代码、股票代码、专利号、产品型号和项目编号提取;
实体描述语义向量生成。
组织机构后缀可以在候选召回时被忽略,但不直接据此确定两个实体属于同一对象。
S107:建立多级实体候选索引
建立:
外部标识精确索引;
标准名称及别名倒排索引;
实体类型索引;
按照实体类型划分的语义向量索引。
待匹配实体的候选实体集合为外部标识候选、名称别名候选和语义向量候选的并集,并通过实体类型兼容矩阵进行过滤。
由此,待匹配实体仅需与有限数量的候选实体进行比较,而无需与全部历史实体逐一比较。
S108:实体硬冲突检测
在计算实体一致性评分之前,对实体匹配对执行硬冲突检测。
存在以下任一种情况时,禁止实体融合:
两个实体具有属于同一标识命名空间且被配置为唯一的不同外部标识;
两个实体的实体类型属于预设互斥类型;
两个实体的有效时间或空间位置相互冲突;
两个实体具有相互排斥的产品型号、项目编号或业务角色;
原文明确表示两个实体为不同对象。
硬冲突判断优先于名称相似度和语义相似度判断。
S109:实体多特征融合判断
对于不存在硬冲突的实体匹配对,获取:
外部标识匹配特征;
名称匹配特征;
别名匹配特征;
实体类型兼容特征;
上下文关联特征;
描述语义相似特征;
来源结构关联特征。
实体一致性评分按照下式计算:
其中,fᵢ为第i项特征值,取值范围为0至1;wᵢ为对应特征权重;当某项特征具有有效输入时,δᵢ取1,否则取0。
在一种实施方式中:
当最高评分不低于第一阈值,且最高评分与次高评分之差不低于评分间隔阈值时,执行自动融合;
当最高评分位于第二阈值与第一阈值之间,或者评分间隔不足时,生成待确认记录;
当最高评分低于第二阈值时,保持实体独立。
第一阈值可以设置为0.85,第二阈值可以设置为0.65,评分间隔阈值可以设置为0.08。上述数值为示例,可以根据实体类型或验证数据进行调整。
S110:生成统一实体
实体融合后生成统一实体记录,包括:
entity_id;
标准实体名称;
原始名称集合;
别名集合;
实体类型;
外部标识集合;
实体属性集合;
来源文本分块集合;
融合证据;
实体版本号。
对于存在冲突的实体属性,不直接覆盖,而是分别保存属性值、来源和有效时间。
S111:关系类型归一
建立关系本体。每个标准关系类型至少包括:
标准关系标识;
原始关系表达集合;
等价关系组;
上位关系和下位关系;
关系方向转换规则;
允许的主体类型和客体类型;
时间及限定属性配置。
只有被配置为等价关系的原始关系表达才归一为同一标准关系类型。
例如,“采购”“购买”“购入”可以归一为采购关系;“持股”与“控股”分别保留为不同标准关系,但可以具有共同的上位关系。
S112:关系实体映射及关系唯一标识生成
将关系主体和关系客体转换为统一实体标识。
根据以下字段生成关系唯一标识:
其中:
SID为主体统一实体标识;
RID为标准关系标识;
OID为客体统一实体标识;
T为有效时间或事件标识;
P为关系极性;
Q为关系限定属性摘要。
关系限定属性包括持股比例、交易金额、币种、产品型号、项目编号、空间位置和关系状态中的至少一种。其中:
SID = 主体mention_id映射得到的entity_id
OID = 客体mention_id映射得到的entity_id
RID = 原始关系经过关系本体归一得到的canonical_relation_id
S113:关系去重及证据聚合
具有相同关系唯一标识的关系候选被划分至同一关系证据组。
系统根据来源发布主体、来源地址、发布时间和文本内容指纹,将转载或近重复来源划分至同一来源簇。
每一来源簇在计算关系可信度时仅贡献一次,从而避免同一内容被多个网站转载后重复提高关系可信度。
系统保存:
来源文档和文本分块;
原文位置和支持文本;
原始关系表达;
抽取置信度;
独立来源簇数量;
支持证据和冲突证据;
关系可信度。
S114:知识图谱事务化存储
根据文档标识、文档版本、文本分块标识、原文位置和处理模型版本生成幂等键。
在同一数据库事务中完成:
统一实体新增或更新;
实体融合后的关系端点迁移;
关系新增或更新;
来源证据写入;
实体融合操作日志写入;
实体和关系版本更新。
任一步骤失败时,回滚本次事务,避免实体、关系和证据处于不一致状态。
S115:增量更新
新增或修改文档进入系统时:
比较新旧文档内容指纹;
仅处理新增或变化的文本分块;
使用已有实体候选索引匹配新增实体;
根据关系唯一标识判断关系是否已存在;
根据幂等键避免重复写入;
使已删除或修改内容对应的旧版本证据失效;
重新计算实体可信度和关系可信度;
当关系不存在有效证据时,将其标记为失效状态。
3.2 关键创新点
创新点1:多级候选检索与硬冲突门控相结合
先通过外部标识、名称别名和类型分区语义向量索引缩小候选范围,再通过外部标识、实体类型及时空属性执行硬冲突判断,在提高检索效率的同时降低同名实体误融合概率。
创新点2:基于有效特征和评分间隔的实体融合
评分时自动忽略缺失特征,并同时考虑最高候选评分和最高、次高候选之间的评分间隔,避免多个候选实体得分接近时直接执行错误融合。
创新点3:包含时间、极性和限定属性的关系去重
关系去重不再仅依据主体、关系和客体,而是进一步考虑有效时间、关系极性以及持股比例、金额、型号等限定属性,避免不同关系事实被错误合并。
创新点4:基于来源独立性的关系证据聚合
对转载和近重复来源进行依赖性聚类,同一来源簇在可信度计算中仅贡献一次,同时保留支持证据和冲突证据。
创新点5:面向增量构建的幂等事务机制
通过文档内容指纹、幂等键、实体及关系版本和融合操作日志,实现实体融合、关系迁移和证据写入的事务一致性。
四、有益效果
相比现有技术,本发明至少具有以下效果:
减少新增实体与历史实体之间的比较数量;
降低中文实体重复节点数量;
降低同名或近似名称实体的误融合概率;
提升跨文本分块实体关联能力;
防止不同时间、极性或限定属性的关系被错误去重;
减少重复关系边;
避免转载来源被重复计入可信度;
保留实体融合和关系去重依据,提高知识图谱可追溯性;
保证增量更新过程中的幂等性和数据一致性。
五、权利要求书
权利要求1
一种基于多特征融合的中文知识图谱实体融合与关系去重方法,其特征在于,包括:
获取中文文本数据,对所述中文文本数据进行规范化和结构解析,并划分为多个文本分块,同时保存文本分块与原始文本之间的位置映射;
对所述文本分块执行实体关系抽取,得到实体候选数据和关系候选数据;
对所述实体候选数据进行名称规范化、别名识别、外部标识提取和语义表示处理;
基于外部标识精确索引、名称及别名倒排索引和类型分区语义向量索引中的至少两种索引,生成待匹配实体对应的候选实体集合;
对待匹配实体与候选实体组成的实体匹配对执行硬冲突检测,并对不存在硬冲突的实体匹配对获取名称、别名、外部标识、实体类型、上下文、语义及来源结构中的多个匹配特征;
基于具有有效输入的匹配特征计算实体一致性评分,并根据所述实体一致性评分以及最高评分与次高评分之间的评分间隔确定实体融合状态;
将确定属于同一实体对象的多个实体映射至同一统一实体标识,并合并实体属性、来源信息和融合证据;
基于关系本体对所述关系候选数据的关系类型、关系方向和关系限定属性进行标准化;
将关系主体和关系客体映射为统一实体标识,并根据主体统一实体标识、标准关系标识、客体统一实体标识、有效时间或事件标识、关系极性和关系限定属性摘要生成关系唯一标识;
对具有相同关系唯一标识的关系候选数据进行来源依赖性聚类和关系证据聚合,生成目标关系数据;
根据幂等键,在同一数据库事务中写入或更新统一实体数据、目标关系数据、来源证据和融合操作日志。
权利要求2
根据权利要求1所述的方法,其特征在于,所述规范化和结构解析包括:
Unicode编码归一化;
繁体中文转换为简体中文;
全角字符转换为半角字符;
标点符号标准化;
标题、章节、段落、列表和表格识别;
原始文本位置与规范化文本位置之间的映射。
权利要求3
根据权利要求1所述的方法,其特征在于,还包括跨文本分块指代消解:
从指代提及所在文本分块及相邻文本分块中获取先行实体候选,根据实体类型兼容程度、文本距离、句法角色和章节主题计算指代匹配评分,并根据指代匹配评分建立指代提及与先行实体之间的关联。
权利要求4
根据权利要求1所述的方法,其特征在于,所述实体一致性评分为:
其中,fᵢ为实体匹配特征值,wᵢ为对应权重;当对应特征具有有效输入时,δᵢ取1,否则取0;
当不存在硬冲突、最高实体一致性评分达到第一预设阈值,且最高评分与次高评分之差达到评分间隔阈值时,执行自动融合;
当最高评分达到第二预设阈值但不满足自动融合条件时,生成待确认记录;
当最高评分低于第二预设阈值时,保持实体独立。
权利要求5
根据权利要求1所述的方法,其特征在于,所述硬冲突包括:
同一标识命名空间下的唯一外部标识冲突;
实体类型互斥;
时间属性或空间属性冲突;
产品型号、项目编号或业务角色冲突;
原文明确表示两个实体为不同对象。
权利要求6
根据权利要求1所述的方法,其特征在于,所述关系本体至少包括标准关系标识、等价关系组、上位关系、下位关系、关系方向转换规则、主体类型约束、客体类型约束和关系限定属性配置;
仅将属于同一等价关系组的原始关系表达归一为同一标准关系类型。
权利要求7
根据权利要求1所述的方法,其特征在于,所述关系唯一标识按照以下字段生成:
其中,SID为主体统一实体标识,RID为标准关系标识,OID为客体统一实体标识,T为有效时间或事件标识,P为关系极性,Q为关系限定属性摘要。
权利要求8
根据权利要求1所述的方法,其特征在于,所述来源依赖性聚类包括:
根据来源发布主体、来源地址、发布时间和来源文本内容指纹,将相同、转载或满足近重复条件的来源划分至同一来源簇;同一来源簇在关系可信度计算中仅贡献一次,并分别保存支持证据和冲突证据。
权利要求9
一种基于多特征融合的中文知识图谱实体融合与关系去重系统,其特征在于,包括:
文本处理模块;
实体关系抽取模块;
指代消解模块;
实体规范化模块;
候选检索模块;
冲突检测模块;
实体融合模块;
关系处理模块;
证据聚合模块;
事务存储模块;
所述各模块被配置为执行权利要求1至8任一项所述的方法。
权利要求10
一种电子设备,包括处理器、存储器以及存储于所述存储器中的计算机程序,其特征在于,所述计算机程序被所述处理器执行时,使所述电子设备执行权利要求1至8任一项所述的方法。
权利要求11
一种计算机可读存储介质,其上存储有计算机程序,其特征在于,所述计算机程序被处理器执行时,使所述处理器执行权利要求1至8任一项所述的方法。